
 Worksheets
مراجعة الدرس الأول
Total questions: 60
Worksheet time: 30mins
أي عبارة تصف التعلم العميق بدقة؟
استخدام خوارزميات بحث فقط للعثور على أقصر طريق
استخدام الشبكات العصبية العميقة لتعلم أنماط معقدة
استخدام جداول قرار بسيطة لحساب المتوسطات
استخدام قواعد ثابتة مكتوبة يدويًا لمعالجة البيانات
ما السمة الأساسية للتعلم الموجّه؟
يعتمد على بيانات معنونة لتدريب النموذج
يعمل على بيانات غير معنونة بالكامل
لا يحتاج إلى أي بيانات تدريبية مسبقة
يعتمد على مكافآت آنية فقط عند التنبؤ
أي مهمة تُعد مثالًا نموذجيًا للتعلم غير الموجّه؟
تقدير سعر منزل باستخدام الانحدار
تجميع عناصر متشابهة دون تسميات مسبقة
التنبؤ بدرجات الطلاب من سمات محددة
تصنيف رسائل البريد إلى عادي ومزعج
ما المصطلح الذي يطلق على تحويل النصوص إلى تمثيلات عددية يمكن للآلة معالجتها؟
تحويل السلاسل النصية إلى متجهات عددية
تحويل الصور إلى مصفوفات ألوان
تحويل الرسوم إلى إحداثيات مكانية
تحويل الصوت إلى موجات ترددية
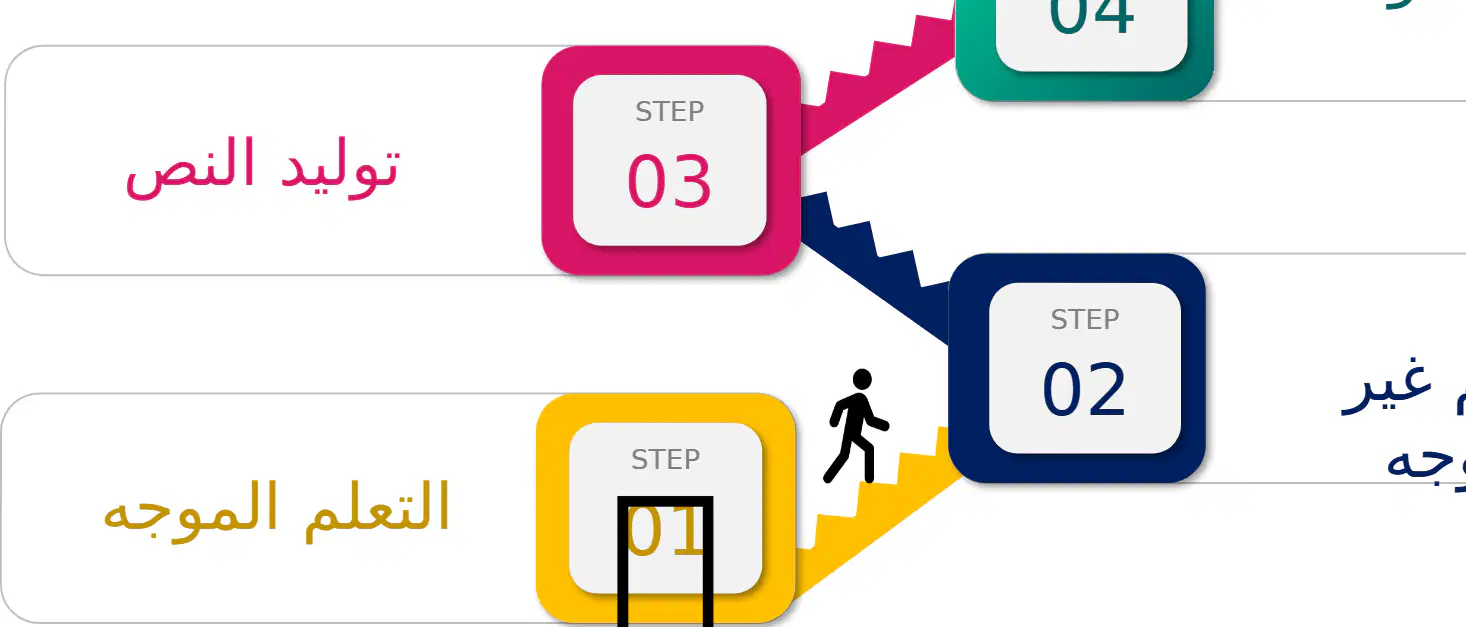
ما الترتيب الصحيح لخطوات مسار التعلم في الوحدة الثالثة كما يظهر في الشكل؟
التعلم الموجه، توليد النص، مشروع الوحدة
التعلم غير الموجه، تعلم موجه، مشروع الوحدة
التعلم الموجه، التعلم غير الموجه، توليد النص، مشروع الوحدة
توليد النص، التعلم غير الموجه، تعلم موجه، مشروع الوحدة
أي عنوان يصف موضوع الدرس الثاني كما هو موضح في الشريحة؟
التعلم غير الموجه
التعلم المعزز العميق
معالجة الصور الطبية
التعلم الموجه المتقدم
أي من النتائج المتوقعة ينسجم مع أهداف الدرس الثاني (الجزء الأول)؟
تصميم قواعد منطقية للأنظمة الخبيرة
تدريب شبكات توليدية للتزييف العميق
استخدام التعلم غير الموجه لفهم النصوص
بناء نماذج أشرافية لتصنيف الصور
ما التقنية التي تُذكر ضمن محتوى الدرس الثاني وتتعلق بخفض عدد الميزات قبل النمذجة؟
تقنيات تقليص الأبعاد
تعزيز التدرج العشوائي
زيادة البيانات الصورية
تنظيم الشبكات العميقة
ما هو التعلم غير الموجّه في سياق فهم النصوص؟
أسلوب يستخدم بيانات معنونة للتنبؤ بالملصقات
نهج يعتمد على قواعد مكتوبة يدوياً لمعالجة اللغة
نوع يتعلم من بيانات غير معنونة لاكتشاف الأنماط
طريقة تدريب خاضعة لإشراف خبير أثناء كل خطوة
أي عبارة تصف الهدف الأساسي لخوارزميات التجميع في معالجة النصوص؟
ضم المستندات المتشابهة معاً بدون تسميات مسبقة
تصنيف المستندات إلى فئات معلومة مسبقاً
ترجمة الجمل بين لغتين بشكل مباشر
توليد ملصقات جديدة باستخدام نماذج لغوية
ما الفائدة الرئيسية من تقنيات تقليص الأبعاد عند التعامل مع تمثيلات النصوص عالية الأبعاد؟
زيادة عدد الخصائص لضمان الدقة القصوى
إزالة جميع الضوضاء حتى تصبح البيانات مثالية
تقليل عدد الخصائص مع الحفاظ على المعلومات المهمة
تحويل النصوص إلى صور لاستخدامها بصرياً
النماذج التوليدية تُستخدم غالباً في أي نوع من المهام النصية؟
إدارة قواعد البيانات العلائقية
قياس دقة المصنفات تحت الإشراف
توسيم المستندات بفئات محددة سلفاً
اكتشاف الاختلافات والشذوذ في البيانات
أي مما يلي مثال عملي على استخدام التجميع في مجال التسويق القائم على النصوص؟
تجميع العملاء المتشابهين في السلوك الشرائي
توليد نصوص جديدة لمدونة الشركة
تعيين فئة المنتج من خلال بيانات التدريب
ضغط الصور لتسريع تحميل الصفحات
لماذا يُعد اكتشاف الأنماط والعلاقات جوهرياً في التعلم غير الموجّه للنصوص؟
لأنه يعمل بدون إشراف ويحتاج بنية خفية للبيانات
لأنه يستبدل كل الخصائص بمتغير وحيد
لأنه يعتمد على التصحيح اليدوي للملصقات
لأنه لا يتعامل مع البيانات عالية الأبعاد مطلقاً
أي تقنية تُستخدم لتقليل عدد وحدات البكسل في الصورة كتشبيه لتقليل الأبعاد في البيانات النصية؟
الترميز الأحادي للملصقات
ضغط الصورة لتقليل دقة البكسل
التصفية بالترددات المنخفضة فقط
تكميم الألوان لعدد أوسع من الدرجات
أنت تملك مجموعة كبيرة من المقالات غير الموسومة. أي نهج هو الأنسب لتجميع المقالات التي تتناول مواضيع متقاربة؟
تطبيق خوارزمية تجميع مثل K-means أو هرمي
بناء مصنف إشرافي باستخدام بيانات معنونة
استخدام نموذج ترجمة آلية عصبي ثنائي اللغة
الاعتماد على مطابقة الكلمات المفتاحية فقط
لإنشاء تمثيل مضغوط لمعاني الكلمات قبل التجميع، ما الخطوة الأنسب؟
إبقاء جميع السمات دون أي تغيير
حذف كل الكلمات الشائعة دون بدائل دلالية
تقليل الأبعاد لاستخلاص الخصائص الأكثر أهمية
زيادة الأبعاد بإضافة كل n-gram ممكن
في مشروع لاكتشاف الشذوذ في الرسائل النصية، أي خيار يعكس مسار عمل منطقي؟
الاعتماد على ملصقات تاريخية لإرشاد التعلم
وضع تسميات يدوية لكل رسالة أولاً ثم التصنيف
تجميع الرسائل المتشابهة ثم استخدام نموذج توليدي لاختلاف
إزالة جميع الميزات ثم قياس المسافات الإقليدية
تشير العبارة في الصورة الأولى: هل يمكن استخدام الذكاء الاصطناعي للكشف عن الأنماط والعلاقات غير الواضحة؟ ما التقنية التي تجيب بنعم على هذا السؤال عند غياب التسميات؟
التعلم غير الموجّه لاكتشاف البنية الخفية
التعلم الخاضع لتقييم يدوي مستمر
التعلم بالإشراف مع بيانات معنونة فقط
التعلم المعزز بمكافآت فورية ثابتة
ما عدد المجلدات الموضوعية في مجموعة بيانات مقالات BBC المستخدمة في هذا الدرس؟
خمسة مجلدات موضوعية منفصلة
أربعة مجلدات موضوعية مرتبة
ثلاثة مجلدات موضوعية أساسية
ستة مجلدات موضوعية متنوعة
أي من التالي يمثل تصنيفات المقالات في هذه المجموعة؟
السفر والطقس والحوادث
الصحة والتعليم والطعام
الأعمال والسياسة والرياضة
العلوم والصحة والسفر
ما الغرض من الدالة listdir في الشيفرة المستخدمة لتحميل البيانات؟
قراءة محتوى ملفات النص سطرًا
عرض أسماء المجلدات والملفات
دمج القوائم بعد القراءة
تحويل الترميز إلى UTF-8 تلقائيًا
لماذا يُفتح الملف النصي بترميز utf8 في الشيفرة؟
لتقليل حجم الملفات النصية
لتمكين ترتيب أبجدي ثابت
لتسريع عمليات القراءة فقط
لدعم حروف غير أسكي محتملة
أي اختيار يعبّر بدقة عن القائمتين اللتين تُجمع فيهما البيانات بعد القراءة؟
قائمة للعناوين وقائمة للروابط
قائمة للنصوص وقائمة للتصنيفات
قائمة للصور وقائمة للوسوم
قائمة للتواريخ وقائمة للأحجام
في الشيفرة، ما السبب لاستخدام random.shuffle على قائمة مقترنة من النصوص والتسميات؟
لتحويل النصوص إلى أحرف صغيرة فقط
لإعادة تسمية المجلدات تلقائيًا
لإزالة المقالات المكررة نهائيًا
للحفاظ على اقتران النص مع تصنيفه
إذا تمت قراءة الملفات داخل كل مجلد دون استخدام listdir للمجلد الأعلى، فما المشكلة المتوقعة؟
سيُضاعف عدد المقالات المقروءة تلقائيًا
ستُقرأ ملفات بلا ترميز صحيح دومًا
ستُحفظ النصوص دون تسميات موضوعية
سيُمنع فتح أي ملف نصي نهائيًا
ما المقصود بتجميع المستندات؟
ترتيب المستندات زمنياً حسب تاريخ الإنشاء
تقسيم المستندات إلى عناقيد حسب التشابه
ضغط المستندات لتقليل الحجم التخزيني
ترجمة المستندات بين لغات متعددة
أي العبارة تصف البيانات المستخدمة في التجميع؟
بيانات ثنائية بصيغة صور وأصوات فقط
بيانات معنونة مع فئات معروفة مسبقاً
بيانات مشفرة لا يمكن معالجتها آلياً
بيانات غير معنونة تحتاج اكتشاف البنية
ما الهدف الرئيس من خوارزميات التجميع؟
بناء نموذج تنبؤي لوسم الفئات المعروفة
تحويل النصوص إلى صور قابلة للعرض
إزالة الضجيج من البيانات قبل التصنيف
جمع العناصر المتشابهة وفصل غير المتشابهة
أي مقياس مسافة يقيس الخط المستقيم بين نقطتين في فضاء متعدد الأبعاد؟
تشابه كوساين للزوايا
مسافة مانهاطن للشبكات
المسافة الإقليدية بين المتجهات
تشابه جاكارد للمجموعات
متى يكون تشابه كوساين مساوياً للواحد تقريباً بين متجهين نصيين؟
عندما يكون اتجاههما متطابقاً تقريباً
عندما تكون إحداثياتهما جميعاً صفراً
عندما تكون المسافة الإقليدية بينهما كبيرة
عندما تتعامد الزاوية بينهما تماماً
أي عبارة أدق حول اختيار مقياس التشابه للنصوص الممثلة بمتجهات؟
تعد مقاييس المسافة شائعة مثل الإقليدية
لا تستخدم أي مقاييس مسافة مع النصوص
يجب استخدام جاكارد دوماً مع كل النصوص
تتفوق مسافة مانهاطن في كل الحالات
ما الذي يميز التجميع الهرمي؟
يعمل فقط مع بُعدين أو أقل
يعتمد على وسيوم مسبقة للفئات
يتطلب عدد العناقيد قبل البدء
ينظم النقاط في بنية شجرية بعُقد
أي عامل يؤثر في جودة نتائج التجميع؟
حجم الشاشة المستخدمة للعرض
لون واجهة البرنامج الرسومية
طريقة تمثيل البيانات بالمتجهات
ترتيب الملفات في مجلدات
ما وظيفة تحديد عدد العناقيد المناسب ضمن التجميع التكتلي؟
اختيار العدد المناسب من العناقيد
تعيين الأوزان لكل كلمة عشوائياً
تحويل المتجهات إلى ترميز ثنائي
إلغاء المستندات ذات التكرار العالي
أي التالي وصف صحيح لمسافة كوساين مقارنة بالإقليدية؟
تعتمد على إحداثي واحد فقط
تتطلب جذر مجموع المربعات
تقيس تماثل الاتجاه لا الطول
تزداد بزيادة الفروق المطلقة
في سياق النصوص، ما فائدة تقنية تكرار المصطلح–تكرار المستند العكسي؟
توليد عناوين تلقائية للمقالات
تمثيل المستندات بمتجهات وزنية فعّالة
ضغط النصوص إلى أحجام أصغر كثيراً
إزالة علامات الترقيم من الجمل
أي عملية تعد مثالاً على التعلم غير الموجه؟
تصنيف البريد كرسالة مزعجة
اكتشاف اللغة في النص تلقائياً
تجميع المستندات حسب التشابه
تنبؤ أسعار الأسهم المستقبلية
ما الهدف من تحديد العدد الأمثل للعناقيد في خوارزميات التجميع؟
زيادة عدد الأبعاد المستخدمة دائمًا
تقليل حجم مجموعة البيانات فقط
تحسين دقة النتائج وقابليتها للتفسير
إلغاء الحاجة لمرحلة المعالجة المسبقة
ماذا يحدث غالبًا إذا كان عدد العناقيد كبيرًا جدًا؟
تقل المسافات داخل كل عنقود
يزداد الفصل بين العناقيد المختلفة
تتحسن قابلية التعميم بشكل ملحوظ
تكون المجموعات محدودة جدًا وبدون معنى
أي عبارة تصف مقیاس التراص Compactness؟
يحسب أقصر مسافة بين أي نقطتين في البيانات
يعتمد على عدد الأبعاد المستخدمة في القياس
يعتمد على مجموع المسافات بين النقاط ضمن كل عنقود
يقيس متوسط المسافة بين مراكز العناقيد فقط
عند استخدام مقياس التراص لتحديد عدد العناقيد، ما الهدف الحسابي؟
جعل جميع العناقيد متساوية الحجم دائمًا
تقليل مجموع المسافات داخل العناقيد إلى الحد الأدنى
تعظيم عدد النقاط داخل كل عنقود
تعظيم المسافة بين أي نقطتين عشوائيتين
أي من التالي يصف مقياس الفصل Separation بدقة؟
يحسب متوسط المسافة بين النقاط في العناقيد المختلفة
يحسب مجموع المسافات داخل كل عنقود فقط
يعتمد على عدد النقاط في كل عنقود مباشرة
يقيس التراص حول مركز واحد ثابت
إذا كان عدد العناقيد منخفضًا جدًا، فما النتيجة المتوقعة؟
تمتد المجموعات على نطاق واسع جدًا
يتحسن الفصل بين العناقيد بوضوح
تزداد قابلية تفسير كل مجموعة
تصبح المسافات داخل العناقيد أصغر
أي اختيار يعكس توازنًا جيدًا عند تقييم التجميع؟
عدد عناقيد كبير جدًا مع تراص ضعيف
تراص داخلي منخفض وفصل داخلي مرتفع
عدد عناقيد قليل جدًا مع فصل ضعيف
تراص داخلي مرتفع وفصل بين العناقيد مرتفع
ما الدور الأساسي لأداة TfidfVectorizer في معالجة النصوص؟
توليد عناوين تلقائية للوثائق النصية
تحويل النص إلى تمثيل عددي موزون بتردد المصطلح
ترجمة النصوص بين لغات متعددة
ضغط الملفات النصية لتقليل الحجم التخزيني
أي عبارة تصف بشكل أدق التجميع الهرمي التجميعي Agglomerative Clustering؟
يستخدم الانحدار الخطي للتنبؤ بالتصنيفات
يقسم عنقوداً كبيراً إلى عناقيد أصغر دفعة واحدة
يبني عناقيد بدمج الأقرب تدريجياً في شجرة
يعتمد فقط على المسافات المانهاتنية دون غيرها
في بايثون، أي استيراد صحيح لاستخدام التجميع الهرمي التجميعي من scikit-learn؟
from scipy.cluster import AgglomerativeClustering
from sklearn.tree import AgglomerativeClustering
from yellowbrick.cluster import AgglomerativeClustering
from sklearn.cluster import AgglomerativeClustering
تُستخدم مكتبة scipy.cluster.hierarchy في هذا السياق من أجل:
تصوير وبناء مخططات الدندروغرام للهرميات
تنظيف النصوص من علامات الترقيم
تحويل الصور إلى نصوص باستخدام OCR
تحسين سرعة التدريب للشبكات العميقة
عند إنشاء كائن TfidfVectorizer بالوسيط min_df=10، ما الأثر المتوقع؟
استخدام خوارزمية التجميع بدلاً من المتجهات
تحويل كل النصوص إلى أحرف صغيرة إجبارياً
مضاعفة أوزان الكلمات الأكثر تكراراً دائماً
تجاهل الكلمات التي لا تظهر في عشرة مستندات على الأقل
ما الخطوة الصحيحة لتلائم وتحوّل مجموعة وثائق نصية باسم bbc_docs إلى مصفوفة TF‑IDF؟
text_tfidf = vectorizer.fit_transform(bbc_docs)
text_tfidf = vectorizer.predict(bbc_docs)
text_tfidf = vectorizer.compile(bbc_docs)
text_tfidf = vectorizer.describe(bbc_docs)
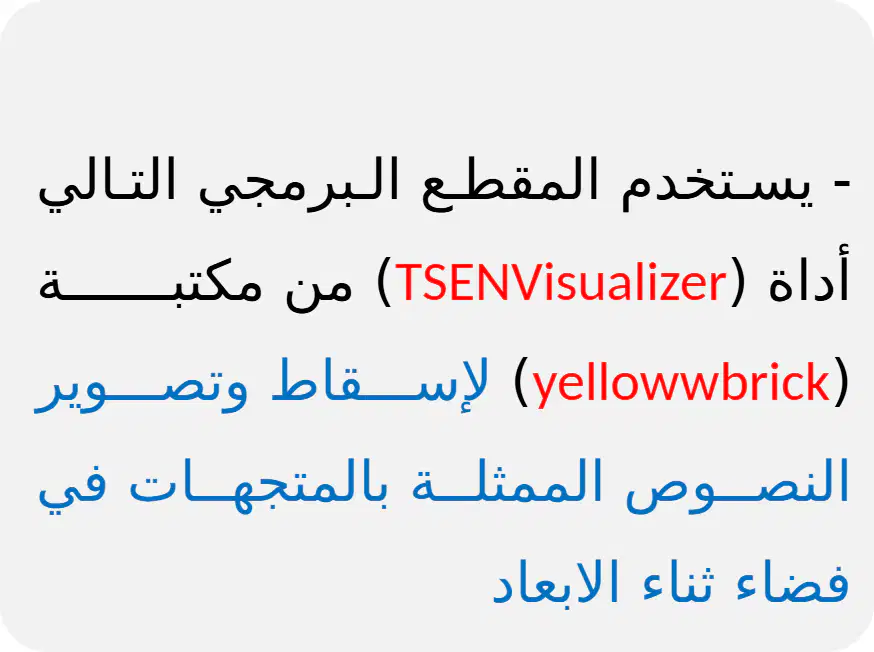
أي أداة من مكتبة yellowbrick تُستخدم لإسقاط وتمثيل نصوص متجهة في بعدين؟
TSNEVisualizer من yellowbrick.text
Dendrogram من yellowbrick.hierarchy
PCAPlotter من yellowbrick.text
AggloView من yellowbrick.cluster
تخيل أنك حصلت على مصفوفة TF‑IDF كبيرة متفرقة. ما فائدة استخدام دالة set_link_color_palette في hierarchy قبل رسم الدندروغرام؟
تحديد ألوان الروابط لتمييز العناقيد بصرياً
تطبيع الأوزان العددية في المتجهات
تحويل المصفوفة المتفرقة إلى مصفوفة كثيفة
اختيار خوارزمية مسافة مختلفة تلقائياً
أي من الفوائد التالية يوضح لماذا يُسهِّل تقليص الأبعاد فهم البيانات عالية الأبعاد؟
إسقاط البيانات في فضاء أقل بعدًا يسهل تصورها
زيادة عدد السمات النشطة يجعل الرسم أوضح دائمًا
تجزئة العيّنات إلى مجموعات كثيرة يزيد الوضوح البصري
تحويل كل سمة إلى فئة منفصلة يوضح العلاقات
ما المفهوم الذي يركّز على اختيار subset من السمات الأصلية الأكثر صلة بالمهمة؟
تعلم المشعب يقدّر بنية غير خطية مخفية
تحويل السمات ينشئ سمات جديدة مندمجة
اختيار السمات يختار سمات أصلية ذات صلة
تجميع البيانات يقسم البيانات إلى فئات
أي تقنية تهدف إلى بناء تمثيلات جديدة من السمات عبر إسقاط خطي مثل PCA؟
تحويل السمات عبر إسقاطات خطية مثل PCA
اختيار السمات عبر مرشحات إحصائية بسيطة
تعلم المشعب عبر خرائط محافظِة محليًا
تقييس السمات عبر التطبيع إلى مدى محدد
في أي حالة يكون تعلم المشعب مناسبًا أكثر من الطرق الخطية؟
عند وجود بنية غير خطية كامنة في البيانات
عند تساوي التباين على جميع المحاور
عند كِبَر العينة وغياب أي ضوضاء
عند كفاية تمثيل خطي واحد لجميع الأنماط
أي سبب يوضح كيف يُحسّن تقليص الأبعاد أداء النموذج؟
توسيع فضاء الميزات يسرّع التدريب دائمًا
زيادة الأبعاد تمنع فرط التكيّف تمامًا
إزالة السمات المهمة يقلل التحيّز دومًا
تقليل التشويش وتكرار السمات يحسن التعميم
طالب لديه مجموعة بيانات تحتوي 200 سمة كثيرٌ منها متشابِه. ما الخطة الأكثر منطقية قبل تدريب نموذج تصنيف؟
إجراء اختيار سمات لتقليل التكرار ثم التدريب
تجاهل التطبيع والتركيز على خوارزمية أعقد
إضافة سمات مُصطنعة لزيادة الأبعاد فورًا
تقسيم البيانات إلى مجموعات دون تقليل أبعاد
أي عبارة تصف تبسيط النموذج عند استخدام تقليص الأبعاد؟
النموذج الأقل أبعادًا أبسط وأسرع تدريبًا
النموذج الأعلى أبعادًا أقل عرضة للضوضاء
النموذج البسيط يتطلب بيانات أكثر دومًا
النموذج المعقّد دائمًا أدق من البسيط