
 Worksheets
Responsi Lab
Total questions: 40
Worksheet time: 22mins
Dalam library Pandas, fungsi mana yang paling efisien untuk mendeteksi jumlah nilai kosong (NaN) di setiap kolom dataset?
df.dropna()
df.isnull().sum()
df.describe()
df.count_na()
Apa fungsi dari parameter inplace=true pada perintah df.dropna(inplace=True) ?
Menyimpan perubahan langsung pada dataframe asli tanpa perlu assignment baru.
Hanya menghapus baris yang semua kolomnya kosong
Membuat salinan baru dari dataframe.
Menghapus kolom, bukan baris.
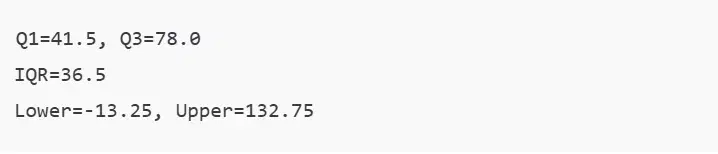
Jika ada nilai Annual Income=137 , maka…
data tersebut outlier
data tersebut bukan outlier
tidak dapat disimpulkan

Fungsi regex r"+\s+" adalah…
Menghapus semua huruf
menghapus angka
menghapus spasi berlebih
menghapus emoticon

Apa yang dilakukan kode ini?
mengecek outlier
menghapus outlier
mengganti outlier dengan batas bawah dan batas atas
mencari tendensi sentral

nilai dari X_norm tersebut akan berada pada rentang___
(-∞, ∞)
(0, 1)
(-1, 1)
(1, 10)
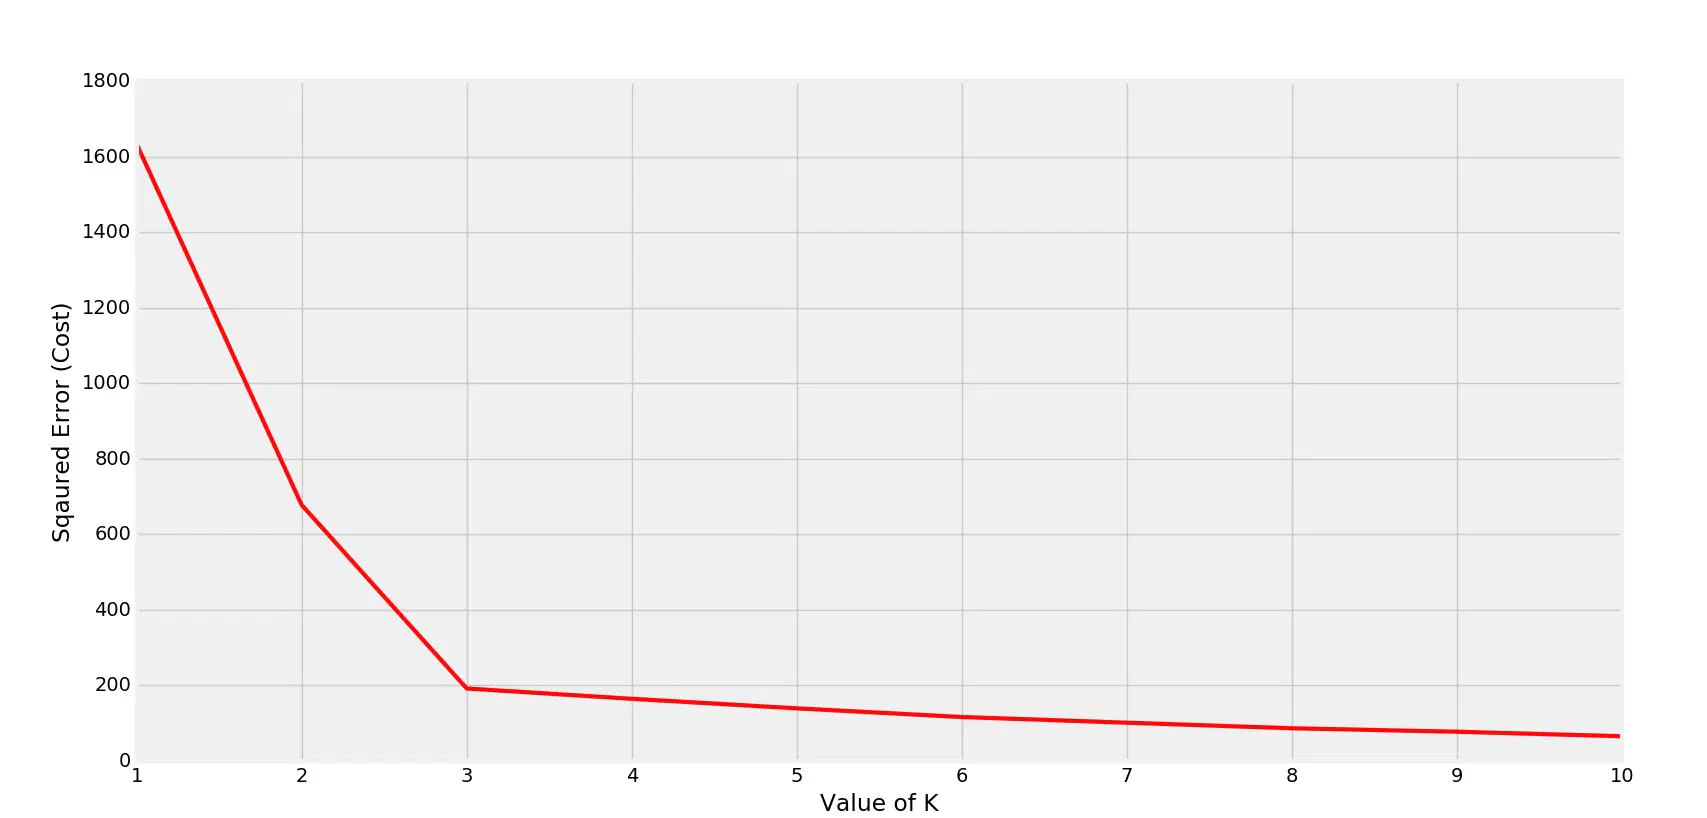
Perhatikan Grafik tersebut !. Berdasarkan grafik tersebut tuliskan jumlah klaster yang optimal
(a)

Perhatikan informasi data tersebut!. Pada data tersebut memiliki missing value?
Ya
Tidak
Tidak dapat ditentukan
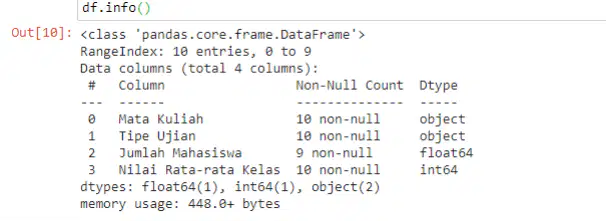
Berdasarkan informasi tersebut, berapa jumlah fitur yang dimili oleh data tersebut?
(a)
Output df.shape adalah (1250,8) . Interpretasi yang benar adalah …
Dataset memiliki 8 baris dan 1250 kolom
Dataset memiliki 1250 baris dan 8 kolom
Dataset memiliki 1250 fitur numerik
Dataset memiliki 8 variabel target
Jika sebuah dataset memiliki banyak kolom kategorikal, informasi struktur yang PALING penting dicek terlebih dahulu adalah …
Nilai maksimum setiap kolom
Distribusi data
Tipe data dan jumlah nilai unik
Korelasi antar fitur
Seorang analis ingin mengganti nilai kosong pada kolom job dengan 'Unknown'. Kode yang benar adalah
df.fill('Unknown')
df.dropna('job')
Untuk mengurutkan dataset berdasarkan kolom age dari terbesar ke terkecil, perintah yang benar adalah
df.sort(age, descending=True)
df.sort_values('age', ascending=False)
df.order_by('age')
df.sort_index('age')
Perintah yang digunakan untuk menghapus baris yang memiliki missing value adalah …
df.remove()
df.dropna()
df.isnull()
df.clean()
Anda menemukan bahwa kolom job memiliki 120 kategori unik, padahal dataset hanya berisi 500 baris. Keputusan manipulasi data yang PALING LOGIS adalah …
Menghapus kolom job
Menggabungkan kategori langka menjadi “Other”
Menormalkan kolom
Melakukan encode dengan label encoding
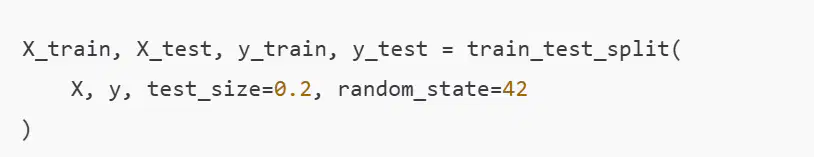
berdasarkan kode tersebut, jika dataset berisi 1000 data, tuliskan jumlah data train yang digunakan untuk membuat model
(a)
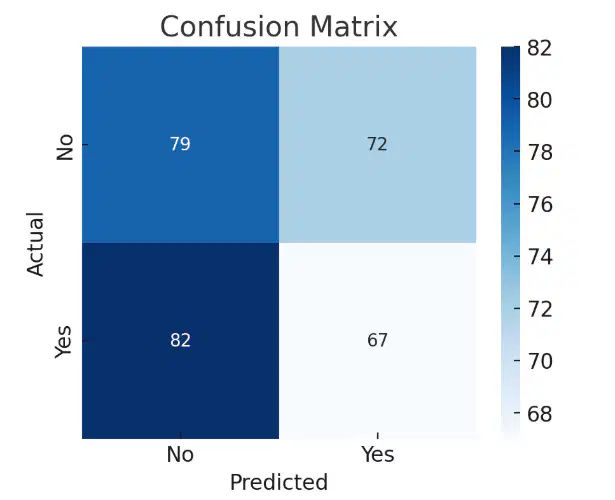
Berapakah jumlah True Positive (TP) pada confusion matrix di atas?
79
72
67
82
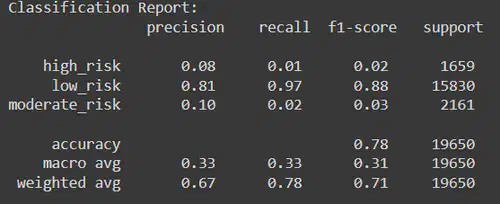
berdasarkan nilai classification report tersebut apakah metrik akurasi adalah metrik yang tepat untuk mengcapture kasus tersebut
ya
tidak
tidak tahu
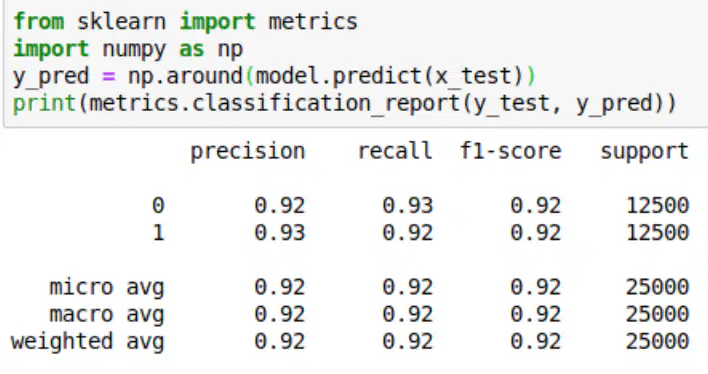
Berdasarkan informasi classification report tersebut, apakah metrik akurasi adalah metrik yang tepat untuk menilai performa model tersebut?
ya
tidak
tidak tahu
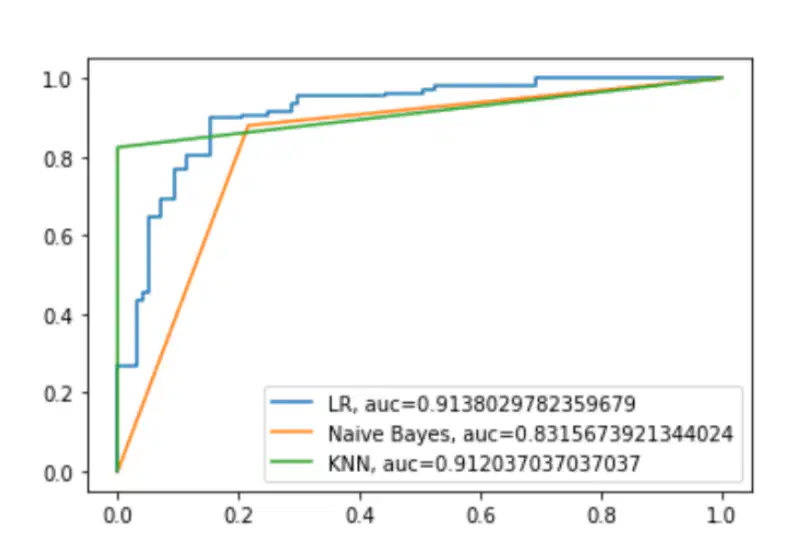
sebuah kasus di selesaikan dengan menggunakan pemodelan Logistic Regression, Naive bayes dan KNN. Hasil pengujian model ditunjukkan oleh kurva ROC-AUC tersebut. Dari hasil tersebut, model manakah yang memiliki performa yang lebih baik
Naive Bayes
KNN
Logistic Regression
Tidak dapat disimpulkan
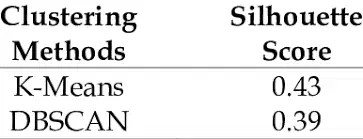
Sebuah kasus diselesaikan dengan pemodelan KMeans dan DBSCAN. Adapun hasil pengujian ditunjukkan oleh tabel tersebut. Berdasarkan tabel tersebut, model manakah yang memiliki kinerja lebih baik?
Kmeans
DBSCAN
Tidak dapat disimpulkan
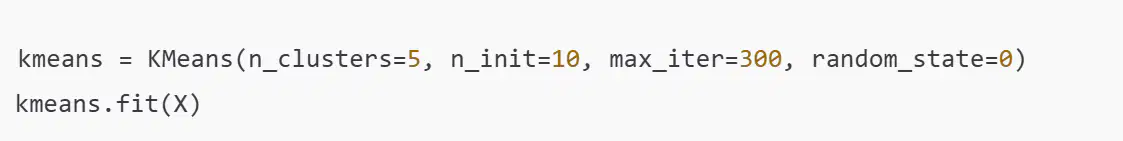
seseorang melakukan modelling dengan Kmeans dengan konfigurasi yang ditunjukkan oleh gambar tersebut. Fungsi n_init=10 pada konfigurasi tersebut adalah …
Mengulang training 10 kali
Mencoba 10 inisialisasi centroid berbeda dan memilih yang terbaik (inertia terendah)
Membagi data menjadi 10 fold
Menetapkan 10 cluster awal tetap
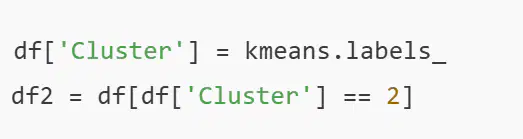
berdasarkan sintaks tersebut, tujuan df2 adalah …
Mengambil centroid cluster 2
Mengambil semua data yang termasuk cluster 2
Menghapus cluster 2
Menggabungkan cluster
Bagaimana cara mengetahui titik core pada scikit-learn DBSCAN setelah data dilatih?
db.core_sample_indices_
db.centroids_
db.cluster_centers_
db.inertia_
Pada DBSCAN, pernyataan yang benar adalah …
Border point punya minimal min_samples tetangga
Core point tidak punya tetangga
Noise point tidak termasuk cluster manapun (label -1)
Semua titik pasti core point
Pipeline yang paling tepat untuk DBSCAN pada fitur numerik berskala berbeda adalah …


Jika hasil DBSCAN menghasilkan banyak label -1, penyebab paling mungkin adalah …
eps terlalu besar
min_samples terlalu kecil
eps terlalu kecil atau min_samples terlalu besar
data tidak bisa di-cluster
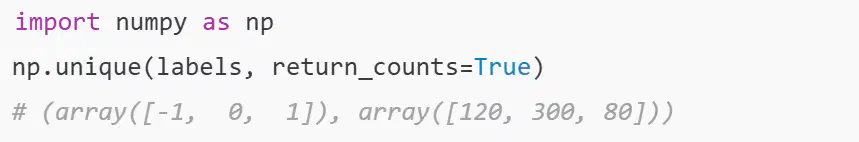
sebuah kasus diselesaikan dengan modelling DBSCAN. hasilnya ditunjukan oleh gambar tersebut. tuliskan berapa jumlah outlier pada data tersebut?
(a)
Pada Algoritma DBSCAN, parameter eps merepresentasikan …
Jumlah cluster yang diinginkan
Radius tetangga (neighborhood) untuk mengukur kepadatan
Skor kualitas cluster
Jumlah fitur yang dipakai
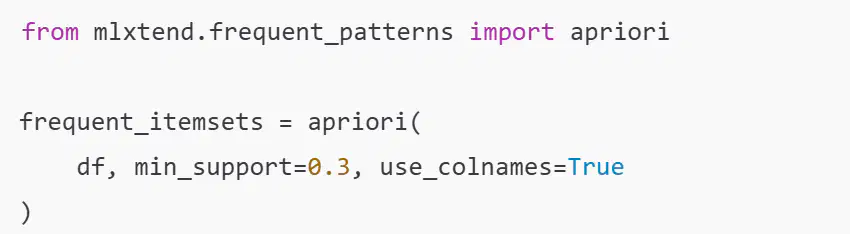
Fungsi utama dari kode tersebut adalah
Menghasilkan aturan asosiasi
Menghasilkan itemset yang sering muncul
Menghitung confidence
Menghapus item jarang

sebuah data dimining dengan aturan asosiasi. berdasarkan output tersebut interpretasi yang dihasilkan oleh aturan tersebut adalah
40% transaksi berisi Milk dan Bread
80% transaksi yang membeli Bread juga membeli Milk
Pembeli Milk 80% juga membeli Bread
Milk dan Bread tidak berhubungan
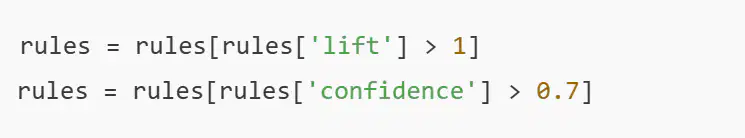
Tujuan utama kode tersebut adalah …
Menghapus semua aturan
Menyimpan aturan yang kuat dan relevan
Mengurutkan aturan
Menghitung support
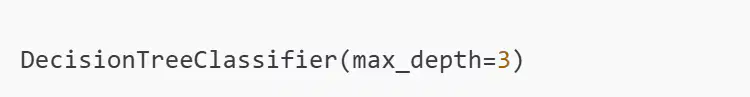
Sebuah kasus diselesaikan dengan decision tree, adapun konfigurasinya ditunjukkan oleh gambar tersebut. Fungsi max_depth pada code tersebut adalah …
Menentukan jumlah fitur
Membatasi kedalaman pohon
Menentukan jumlah data
Mengatur learning rate
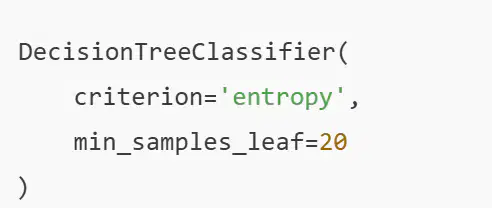
Pada code tersebut, tujuan pengaturan min_samples_leaf adalah …
Menentukan jumlah leaf
Mencegah leaf dengan data terlalu sedikit
Mengatur jumlah fitur
Menghitung entropy
Manakah contoh embedded feature selection?


RFE(LogisticRegression())
RFE(LogisticRegression())


Jika setelah feature selection akurasi turun, kesimpulan yang PALING TEPAT adalah …
Feature selection salah
Dataset rusak
Fitur yang dihapus ternyata informatif
Model harus diganti
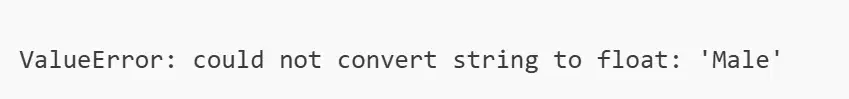
Perhatikan error tersebut. Penyebab paling mungkin adalah …
Missing value belum dihapus
Data belum di-scaling
Fitur kategorikal belum di-encoding
Target salah
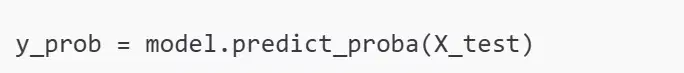
output dari kode tersebut adalah
Label kelas
Nilai residual
Probabilitas tiap kelas
Confusion matrix
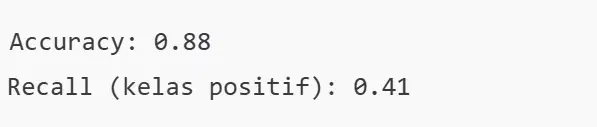
jika model memiliki performa seperti gambar tersebut, maka analisis yang tepat adalah
Model sangat baik
Model gagal total
Model bias ke kelas mayoritas
Model dilatih dari data yang seimbang
Mengapa GaussianNB tidak membutuhkan scaling seketat KNN?
Karena tidak menggunakan jarak
Karena otomatis scaling
Karena fitur dibuang
Karena supervised

