
 Worksheets
Repaso final
Total questions: 26
Worksheet time: 26mins
Si tuviéramos que crear en R una función que realizara una serie de operaciones sobre una lista, ¿qué partícula usaríamos?
“if”, ya que hay que bifurcar entre varias opciones disponibles en la lista.
“else”, ya que es lo que hay que hacer como alternativa a una primera premisa
“for”, ya que hay que recorrer la lista realizando una operación en cada elemento
“library”, ya que hay que cargar la librería específica que hace operaciones en listas
¿Qué diferencia hay entre un histograma y un gráfico de barras?
El histograma se representa en colores distintos y el gráfico de barras no.
No hay diferencias, son el mismo tipo de gráficas.
El gráfico de barras se representa horizontalmente y el histograma es vertical.
El gráfico de barras representa una variable numérica respecto a categorías y el histograma representa la distribución de densidad de una única variable numérica.
En un gráfico de caja o boxplot, ¿qué representan los puntos fuera de los márgenes de la caja?
Son los valores atípicos, valores numéricos extremos que están fuera del rango común de la variable.
Son los valores faltantes, indica que se espera que las posiciones que no se conocen tomen ese valor.
Son marcas del rango máximo y mínimo de la variable, indicadas por los valores más importantes de los datos.
Son embellecedores de la gráfica para que visualmente entendamos mejor el rango de la variable.
La probabilidad de tener una enfermedad es de 0.7. Si tenemos a 20 personas en un hospital, ¿qué distribución sigue la variable “número de personas enfermas en el hospital”?
Discreta, porque toma valores separados.
Exponencial, porque toma valores positivos y en un rango continuo.
Normal, porque tiene un centro y se disipa rápidamente alrededor.
Binomial, porque cuenta la cantidad de éxitos de un suceso con una probabilidad fijada de éxito.
La variable “vida útil de una máquina cosechadora (en horas)” sigue una distribución:
Bernouilli, porque es éxito o fracaso.
Exponencial, porque toma valores positivos y en un rango continuo.
Uniforme discreta, ya que toma ciertos valores separados en un rango finito.
Poisson, ya que cuenta el número de horas hasta estropearse.
En un contraste de hipótesis, la opción conservadora es la hipótesis nula. ¿Qué representa el p-valor?
El grado de verosimilitud de que sucedan los eventos empíricos bajo la hipótesis nula. Si es mayor que 0.05, se rechaza la hipótesis nula.
El grado de verosimilitud de que sucedan los eventos empíricos bajo la hipótesis alternativa. Si es mayor que 0.05, se rechaza la hipótesis nula.
El grado de verosimilitud de que sucedan los eventos empíricos bajo la hipótesis nula. Si es menor que 0.05, se rechaza la hipótesis nula.
Ninguna de las respuestas anteriores es correcta.
Si poseemos un modelo de regresión logística que realiza diagnósticos de tumores malignos y benignos a pacientes y no queremos diagnosticar como sano a ningún enfermo, ¿qué métrica debemos optimizar?
Precission, ya que minimiza los falsos positivos.
Recall, ya que minimiza los falsos negativos.
Accuracy, ya que representa la agregación del rendimiento del modelo.
F1-score, ya que representa la ponderación de ambas métricas.
En estadística, bajo dos hipótesis o modelos que arrojan resultados similares seleccionamos:
La más simple siempre.
La más compleja siempre.
La que tiene menos sesgo, ya que ajusta mejor los datos.
La que tiene un equilibrio mejor entre sesgo y varianza, ya que generalizará mejor.
Si realizas faceting sobre un histograma en base a tres variables discretas con 2, 3 y 5 valores cada una, ¿cuántos histogramas obtendrás como resultado?
10 histogramas, uno por cada combinación de los valores discretos de las variables por las que se factoriza
30 histogramas, uno por cada combinación de los valores discretos de las variables por las que se factoriza
2, 3 o 5, dependiendo en qué variable por las que se factoriza es más predictiva.
Solo uno, el original, solo que se dará información por colores de las variables por las que se factoriza.
¿Cuándo es recomendable estudiar la normalidad de los residuos?
Siempre, en caso de que no sigan una normalidad, podrá indicar que los residuos siguen un sesgo hacia valores altos o bajos.
Solo si el test de Shapiro-Wilk indica normalidad.
No es necesario, con los tests no paramétricos podemos hacernos una idea.
No es necesario, con los tests paramétricos podemos hacernos una idea.
Las distribuciones chi cuadrados, t-Student y F de Snedecor:
Son distribuciones observadas en sucesos de la vida real.
Modelizan multitud de eventos, como la distribución de pesos o alturas en personas.
Son distribuciones definidas en el ámbito de la estadística. Son especialmente útiles en el uso de estadísticos, pero no modelizan eventos de la vida real directamente
Se pueden usar indistintamente para la generación de un estadístico.
Teniendo dos muestras independientes, normales y con varianzas similares, ¿cómo podrías comparar sus medias?
Mediante un test t de Student con hipótesis nula la igualdad de medias.
Mediante un test t de Welch.
Mediante un test F.
Aplicando el teorema central del límite.
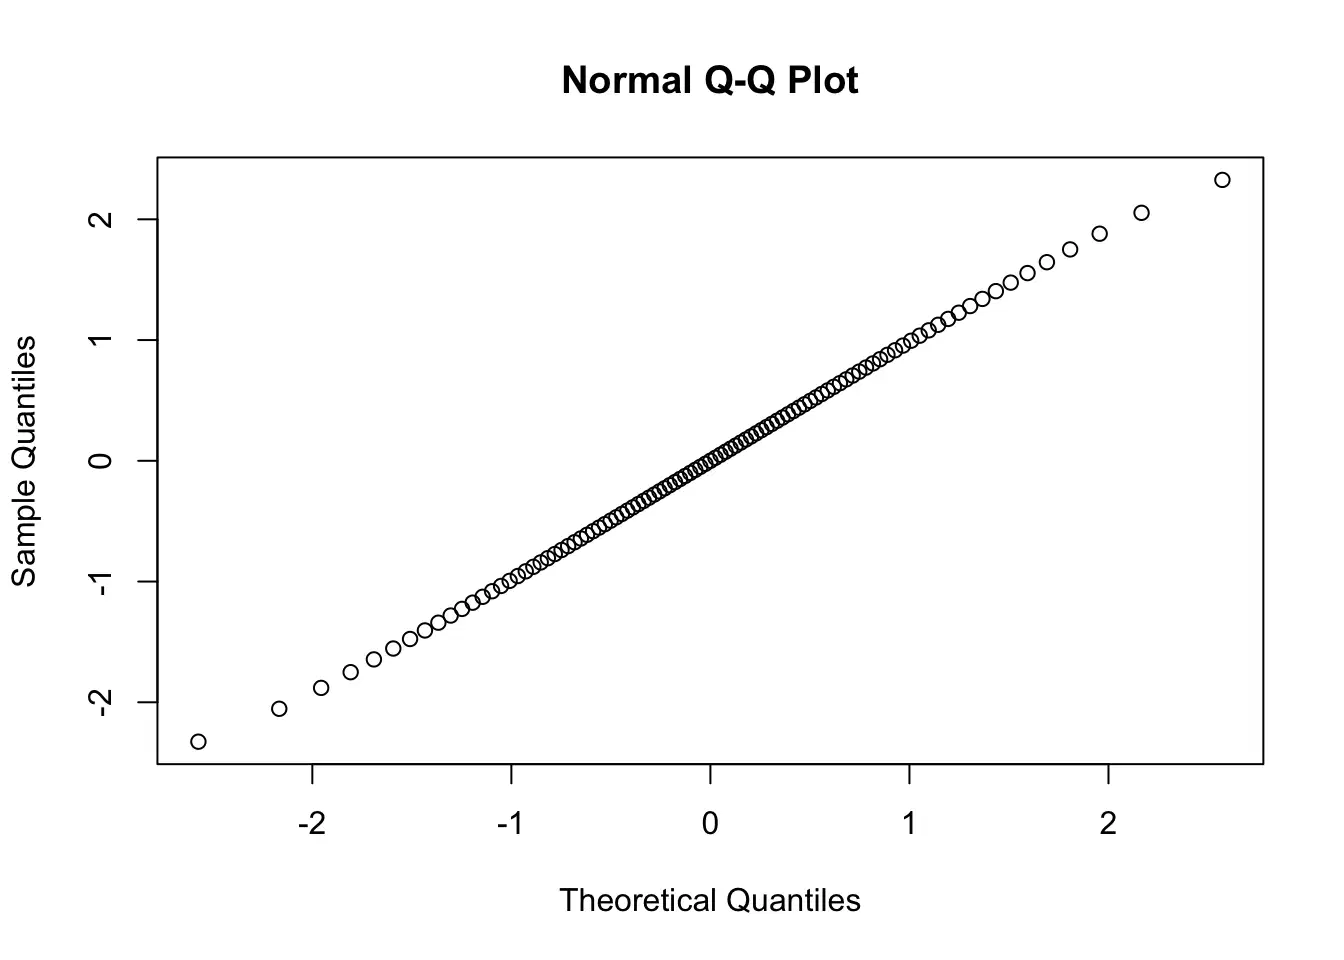
Al comparar los residuos de nuestro modelo con una distribución normal, obtenemos el siguiente QQ plot, ¿qué podemos deducir?
Nada, necesitamos saber la media y la varianza de la distribución normal de referencia para poder deducir resultados.
Que los errores crecen de manera lineal por lo que el modelo no es usable.
Que los errores de nuestro modelo siguen una distribución normal, lo cual es un buen indicador de que el modelo no tiene sesgos.
Nada, un gráfico QQ no se debe utilizar sobre los residuos de un modelo.
Si queremos modelizar una variable binaria, ¿qué tipo de regresión usaremos?
Una regresión potencial.
Una regresión lineal acotándola al intervalo (0, 1).
Una regresión logarítmica.
Una regresión logística.
Si en una regresión lineal múltiple el p-valor de una variable es 0.00023:
Esa variable tiene muy poco poder predictivo y debería ser descartada.
Esa variable explica un 0.0023% la variable objetivo.
Al ser menor que 0.05, se acepta la hipótesis alternativa de que la variable se encuentra relacionada con la variable objetivo.
Se necesitan más datos para poder interpretar el p-valor.
Si un modelo exhibe un rendimiento muy bueno en los datos de entrenamiento, pero muy pobre al extrapolar con datos que nunca ha visto:
El modelo cuenta con un alto sesgo y una baja varianza.
El modelo cuenta con un alto sesgo y una alta varianza
El modelo cuenta con un bajo sesgo y una alta varianza.
El modelo debe reducir sus sesgo para poder predecir mejor.
Con log(odds ratio) = 1.2, ¿qué probabilidad tendremos?
Una probabilidad de 1.2.
Una probabilidad de log(1.2) = 0.182
0.769
El log(odds ratio) no puede ser mayor de 1, no tiene sentido matemático.
Con odds ratio = - 0.3, ¿qué probabilidad tendremos?
1 - 0.3 = 0.7
e-0.3=0.741
0.3
No tiene sentido matemático un odds ratio negativo.
La curva ROC:
Sirve para medir el Accuracy de un modelo logístico.
Es derivable si el suceso a modelar sigue una distibución normal.
Se genera variando el umbral una vez se tiene un modelo logístico probabilístico.
Es independiente a la métrica AUC.
La métrica AUC:
Sirve para medir el F1-score de un modelo logístico.
Se calcula a partir del grado de curvatura de la curva ROC.
Es independiente a la curva ROC.
Cuanto mayor sea su valor, mejor rendimiento mostrará el modelo.
La regularización es un método que:
Se aplica para obtener únicamente modelos logísticos menos sensibles.
Se aplica para obtener únicamente modelos lineales menos sensibles.
Se aplica tanto sobre modelos lineales como logísticos para obtener modelos menos sensibles a los datos de entrada, disminuyendo así el sesgo para aumentar la varianza.
Se aplica tanto sobre modelos lineales como logísticos para obtener modelos menos sensibles a los datos de entrada, aumentando así el sesgo para disminuir la varianza.
En un problema de predicción del precio de la vivienda, tenemos las variables de “poder adquisitivo de la zona”, “metros cuadrados de la vivienda”, “número de habitaciones” y “tamaño del garaje”. ¿Qué tipo de modelo regularizado implementarías?
Un modelo logístico con regularización Lasso, para que las variables menos predictivas tengan un coeficiente nulo.
Un modelo logístico con regularización Ridge, ya que tenemos un conocimiento sobre nuestras variables y consideramos que todas pueden ser predictivas, por lo que no deseamos que ninguna se fuerce a tener un coeficiente nulo.
Un modelo lineal con regularización Ridge, ya que tenemos un conocimiento sobre nuestras variables y consideramos que todas pueden ser predictivas, por lo que no deseamos que ninguna se fuerce a tener un coeficiente nulo.
Un modelo lineal con regularización Lasso, para que las variables menos predictivas tengan un coeficiente nulo ya que debido al gran número de estas no tenemos un conocimiento claro a priori de cuál puede ser más o menos predictiva
Si nos enfrentamos a un problema de clasificación binaria sobre el genoma humano donde cada gen es una posible variable predictora (hay alrededor de 30.000 genes)
Desarrollaremos una modelo lineal con una regularización de Lasso, con el objetivo de obtener un modelo sparse en el que las variables menos predictivas no se tengan en cuenta.
Desarrollaremos un modelo logístico con una regularización de Lasso, con el objetivo de obtener un modelo sparse en el que las variables menos predictivas no se tengan en cuenta.
Desarrollaremos una modelo lineal con una regularización de Ridge, con el objetivo de obtener un modelo sparse en el que las variables menos predictivas no se tengan en cuenta
Desarrollaremos un modelo logístico con una regularización de Ridge, con el objetivo de obtener un modelo sparse en el que las variables menos predictivas no se tengan en cuenta
En una regularización Elastic net con α= 0.7:
Se combinan las penalizaciones de Ridge y Lasso, pero se da un mayor peso a Lasso
Se combinan las penalizaciones de Ridge y Lasso, pero se da un mayor peso a Ridge
Al ser mayor que 0.5, se opta por una regularización de Lasso.
Al ser mayor que 0.5, se opta por una regularización de Ridge.
¿Cómo evolucionan los coeficientes según el parámetro de regularización?
A mayor λ mayores son los coeficientes.
A mayor λ más extremos son los coeficientes (los negativos serán más negativos y los positivos, más positivos).
Conforme λ crece el modelo se regulariza más, por lo que pierde sensibilidad sobre los datos. Es por ello que los coeficientes tienden a 0 o incluso se vuelven 0. La superficie que define el modelo logístico se aplana respecto a las variables predictoras.
Conforme λ crece el modelo se regulariza más, por lo que pierde sensibilidad sobre los datos. Es por ello que los coeficientes tienden a infinito.
¿Cuáles son las funciones de enlace que se consideran en un modelo lineal generalizado para obtener una regresión lineal y una logística?
La función identidad y la función logit correspondientemente.
La función logit en la logística. La regresión lineal no tiene función de enlace.
La función identidad y la función sigmoide correspondientemente.
No se puede determinar, depende del número de variables que se consideren en cada modelo.

